 Aitopkit
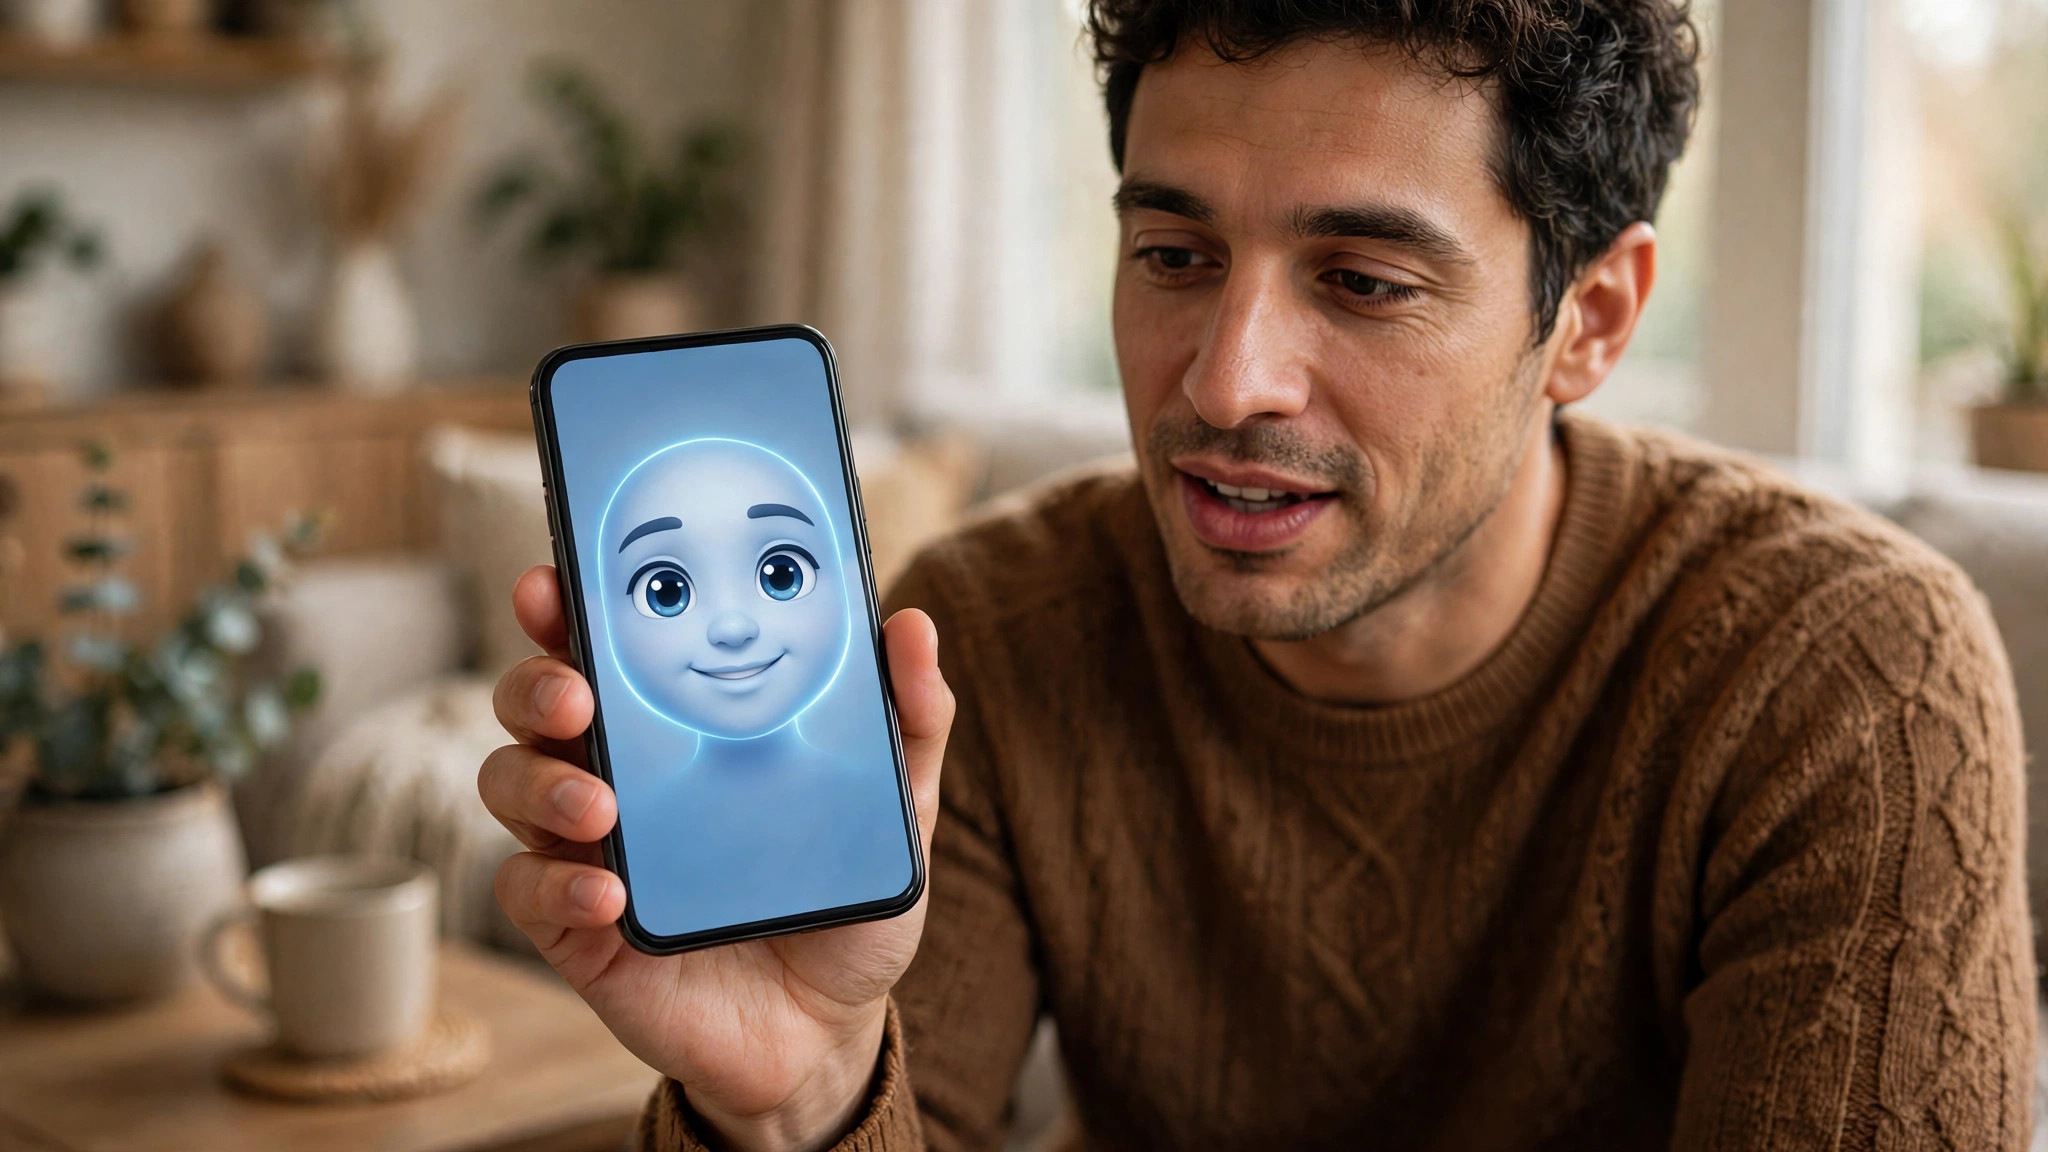
أطلقت Meta ميزة Muse Voice، وهي ميزة جديدة تجلب المحادثات الصوتية الفورية إلى مساعدها للذكاء الاصطناعي Muse. وأُعلن عنها في 6 نوفمبر 2026، وهي تتيح للمستخدمين التحدث مباشرة مع المساعد ومشاهدة صورة رمزية متحركة ترد أثناء حديثهم — بدون كتابة وبدون انتظار ظهور جدار من النص على الشاشة.
الميزة مزيج من التفاعل الصوتي وتقنية الصورة الرمزية الفورية من Meta، التي تصنع تعابير الوجه والإيماءات المصاحبة للمحادثة. وبدلاً من طرح سؤال وقراءة إجابة، يتفاعل المستخدمون مع شخصية رقمية مخصصة تتبدل تعابيرها مع نبرة النقاش وسياقه — وجوه مختلفة لمواضيع مختلفة، على حد تعبير الشركة، ليبدو التبادل أشبه بالحديث مع شريك رقمي منه باستخدام برنامج.
وبدء المحادثة بسيط: ينقر المستخدمون على أيقونة هاتف في الواجهة، ثم يختارون كيف يظهر المساعد. وهناك ثلاثة أوضاع. يعمل وضع «وجهاً لوجه» مثل مكالمة فيديو مع صورة رمزية شخصية للذكاء الاصطناعي. ويضع وضع ثانٍ الصورة الرمزية في وسط محادثة نصية، بحيث يمكن الجمع بين الكلام والنص. ويتيح وضع صوتي فقط للمستخدمين التحدث إلى المساعد دون أي شخصية متحركة على الشاشة إطلاقاً.
وهناك تفصيل يبرز لأي شخص استخدم مساعداً صوتياً من قبل: يمكنك مقاطعة Muse في منتصف الجملة. فيتوقف المساعد ويستمع ويتيح لك إعادة توجيه المحادثة أو طرح سؤال جديد دون انتظار انتهائه من الكلام — تغيير صغير يجعل الصوت يبدو محادثة حقيقية بدلاً من تبادل أدوار.
التخصيص محور العرض. وتقول Meta إن هناك مئات الأصوات والأنماط للاختيار من بينها، ليتمكن المستخدمون من تصميم صوت المساعد ومظهره. وهذا مهم لأن Muse يُقدَّم كهوية رقمية دائمة، وليس مجرد نافذة محادثة أخرى: فهو يتمتع بذاكرة طويلة المدى، تحتفظ بالمعلومات عبر المحادثات مع مرور الوقت لتقديم إجابات أكثر تخصيصاً، وميزات وكيلة مصممة للمساعدة في المهام بدلاً من الإجابة عن الأسئلة فقط. وعلى عكس روبوت Meta AI الذي يظهر داخل خدمات مثل WhatsApp، يتمتع Muse بمظهر وواجهة مميزين خاصين به.
وMuse نفسه منتج شاب — أُطلق في الولايات المتحدة في سبتمبر 2026 ومنذ ذلك الحين طُرح في كندا. ويُطرح Muse Voice في الولايات المتحدة أولاً، على الجوال والويب وMac، مع أسواق أخرى لاحقاً؛ ولم تحدد Meta تواريخ محددة للتوفر الدولي. ويشمل الإعلان أيضاً خططاً لجلب Muse Voice إلى جهاز Muse Charm القادم وإلى نظارات Meta للذكاء الاصطناعي، مجدداً بدون تواريخ إطلاق مرفقة.
وتتناسب الخطوة مع نمط واضح: كل مساعد كبير يتسابق ليصبح شيئاً تتحدث إليه بدلاً من شيء تكتب له. فوضع الصوت في OpenAI وGemini Live من Google والآن Muse Voice من Meta تراهن جميعاً على أن الواجهة التالية للذكاء الاصطناعي منطوقة ومعبّرة وقابلة للمقاطعة. وما إذا كان المستخدمون يفضلون فعلاً الدردشة مع صورة رمزية على قراءة النص سيكون الاختبار الحقيقي — لكن مع بدء الطرح في الولايات المتحدة الآن، فإن Meta على وشك معرفة ذلك على نطاق واسع.
وبالنسبة للمستخدمين، فالسؤال العملي هو ما الذي يستبدله Muse Voice. وتقدمه Meta كطريقة افتراضية لاستخدام Muse، وليس كميزة جانبية: فذاكرة المساعد طويلة المدى وأدواته الوكيلة مصممة ليتم الوصول إليها بالكلام، سواء كان ذلك تخطيط يوم أو صياغة رسالة أو العمل على مهمة دون استخدام اليدين. والأوضاع الثلاثة مهمة هنا — وجهاً لوجه لمحادثة مركزة، والصورة الرمزية داخل النص للاستخدام المختلط، والصوت فقط للقيادة أو المشي — لأنها تتيح للمساعد نفسه أن يناسب لحظات مختلفة بدلاً من فرض واجهة واحدة. والسؤال المفتوح هو توقيت الإطلاق الدولي: مع عدم تحديد تواريخ بعد الطرح في الولايات المتحدة، سيراقب المستخدمون خارج الولايات المتحدة الإعلان التالي.